Hasta ahora, cada sitio debía configurar reglas específicas para cada empresa, pero con esta nueva política podrán expresar su preferencia de exclusión de manera centralizada. La medida responde a solicitudes de editores, organizaciones civiles y reguladores que piden mayor control sobre el uso de sus contenidos1.
Cómo funcionará la nueva señal
La nueva señal en el archivo robots.txt funcionará como una etiqueta de política común que las empresas de IA consultarán antes de utilizar el contenido de un sitio web para entrenar sus modelos1.
Antes, cada empresa tenía su propio nombre de rastreador, lo que obligaba a los editores a mantener listas separadas de reglas para excluirse de cada una. Ahora, un solo comando bastará para impedir el acceso de los rastreadores de OpenAI, Google, Microsoft y Anthropic, siempre que la empresa haya implementado la señal1.
Calendario de adopción y limitaciones
OpenAI no ha dado una fecha concreta, pero anunció que publicará detalles de su implementación en los próximos meses1.
Por el momento, la herramienta aún no protege a los sitios frente a las cuatro compañías a la vez. La adhesión es voluntaria y la señal no reemplaza los controles individuales que cada empresa ofrece. Los sitios podrán seguir usando controles específicos para cada rastreador si así lo desean1.
Otras iniciativas y postura de Meta
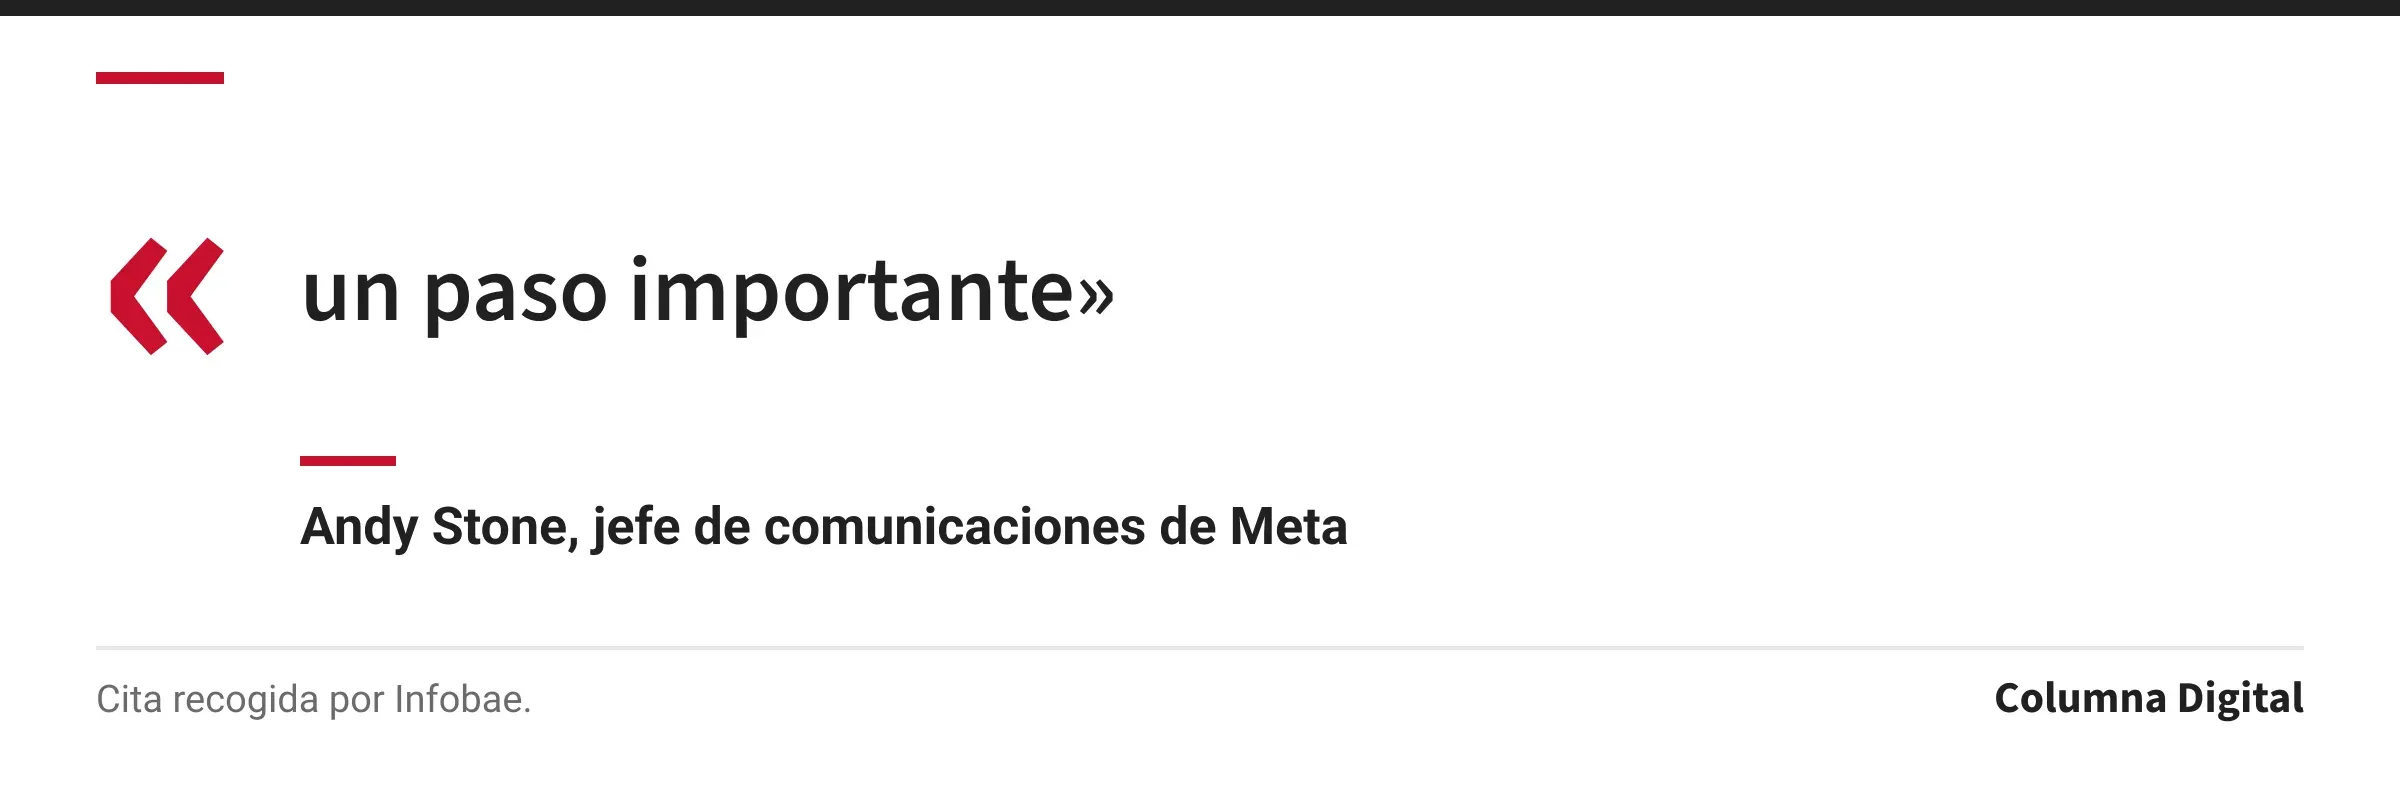
Meta expresó su apoyo a la idea de una señal común, aunque no aclaró si la respetará. Andy Stone, jefe de comunicaciones de Meta, calificó la medida como 'un paso importante' y señaló que la empresa busca colaborar en su implementación1.
Han surgido otras iniciativas, como el estándar Really Simple Licensing, que permite a los sitios cobrar a los rastreadores, y la decisión de Cloudflare de bloquear por defecto a estos programas. El Grupo de Trabajo de Ingeniería de Internet (IETF) sigue discutiendo el resto del vocabulario de preferencias de IA1.
Preguntas frecuentes
¿Qué es el archivo robots.txt y cómo funciona?
El archivo robots.txt es un documento que los sitios web utilizan para indicar a los programas que recorren internet (rastreadores) qué partes pueden visitar. Los editores pueden especificar reglas para permitir o bloquear el acceso a su contenido1.
¿Cómo puedo impedir que mi sitio web sea usado para entrenar IA?
Con la nueva señal común en robots.txt, los sitios web podrán añadir una etiqueta específica para prohibir en un solo paso que OpenAI, Google, Microsoft y Anthropic utilicen su contenido para entrenar sistemas de IA, siempre que estas empresas hayan implementado la señal1.
¿Qué impacto tiene esta medida en el uso de contenido en internet?
La medida permite a los editores controlar de forma centralizada si su contenido puede ser usado para entrenar inteligencia artificial, respondiendo a demandas de editores y reguladores. Sin embargo, la adopción es voluntaria y depende de cada empresa1.
Nota de la Redacción: esta nota se basa en la información disponible al publicarla y se actualizará si otras fuentes aportan más datos.
Fuentes
Texto elaborado por la Redacción de Columna Digital a partir de estas fuentes:
Redacción Columna Digital. Es posible que en la preparación de esta nota se hayan usado herramientas de inteligencia artificial para reunir fuentes, procesar datos, corregir o redactar textos, bajo la supervisión del equipo de Redacción.
Datos basados en información reportada originalmente por Infobae.
Reportar un problema en esta notaPolítica de correcciones
Deja un comentario